Erster Eindruck Claude Fable 5
Anthropic hat gestern mit Claude Fable 5 die nächste Generation seiner Modelle vorgestellt.
Claude Fable 5 and Claude Mythos 5Anthropic spricht von einem deutlichen Sprung im Software Engineering, bei der wissenschaftlichen Recherche und komplexen Langzeitaufgaben. Fable 5 ist die öffentliche Version des neuen Mythos-Modells, während bestimmte Hochrisiko-Fähigkeiten (insbesondere im Bereich Cybersecurity) weiterhin eingeschränkt oder nur ausgewählten Partnern zugänglich sind.
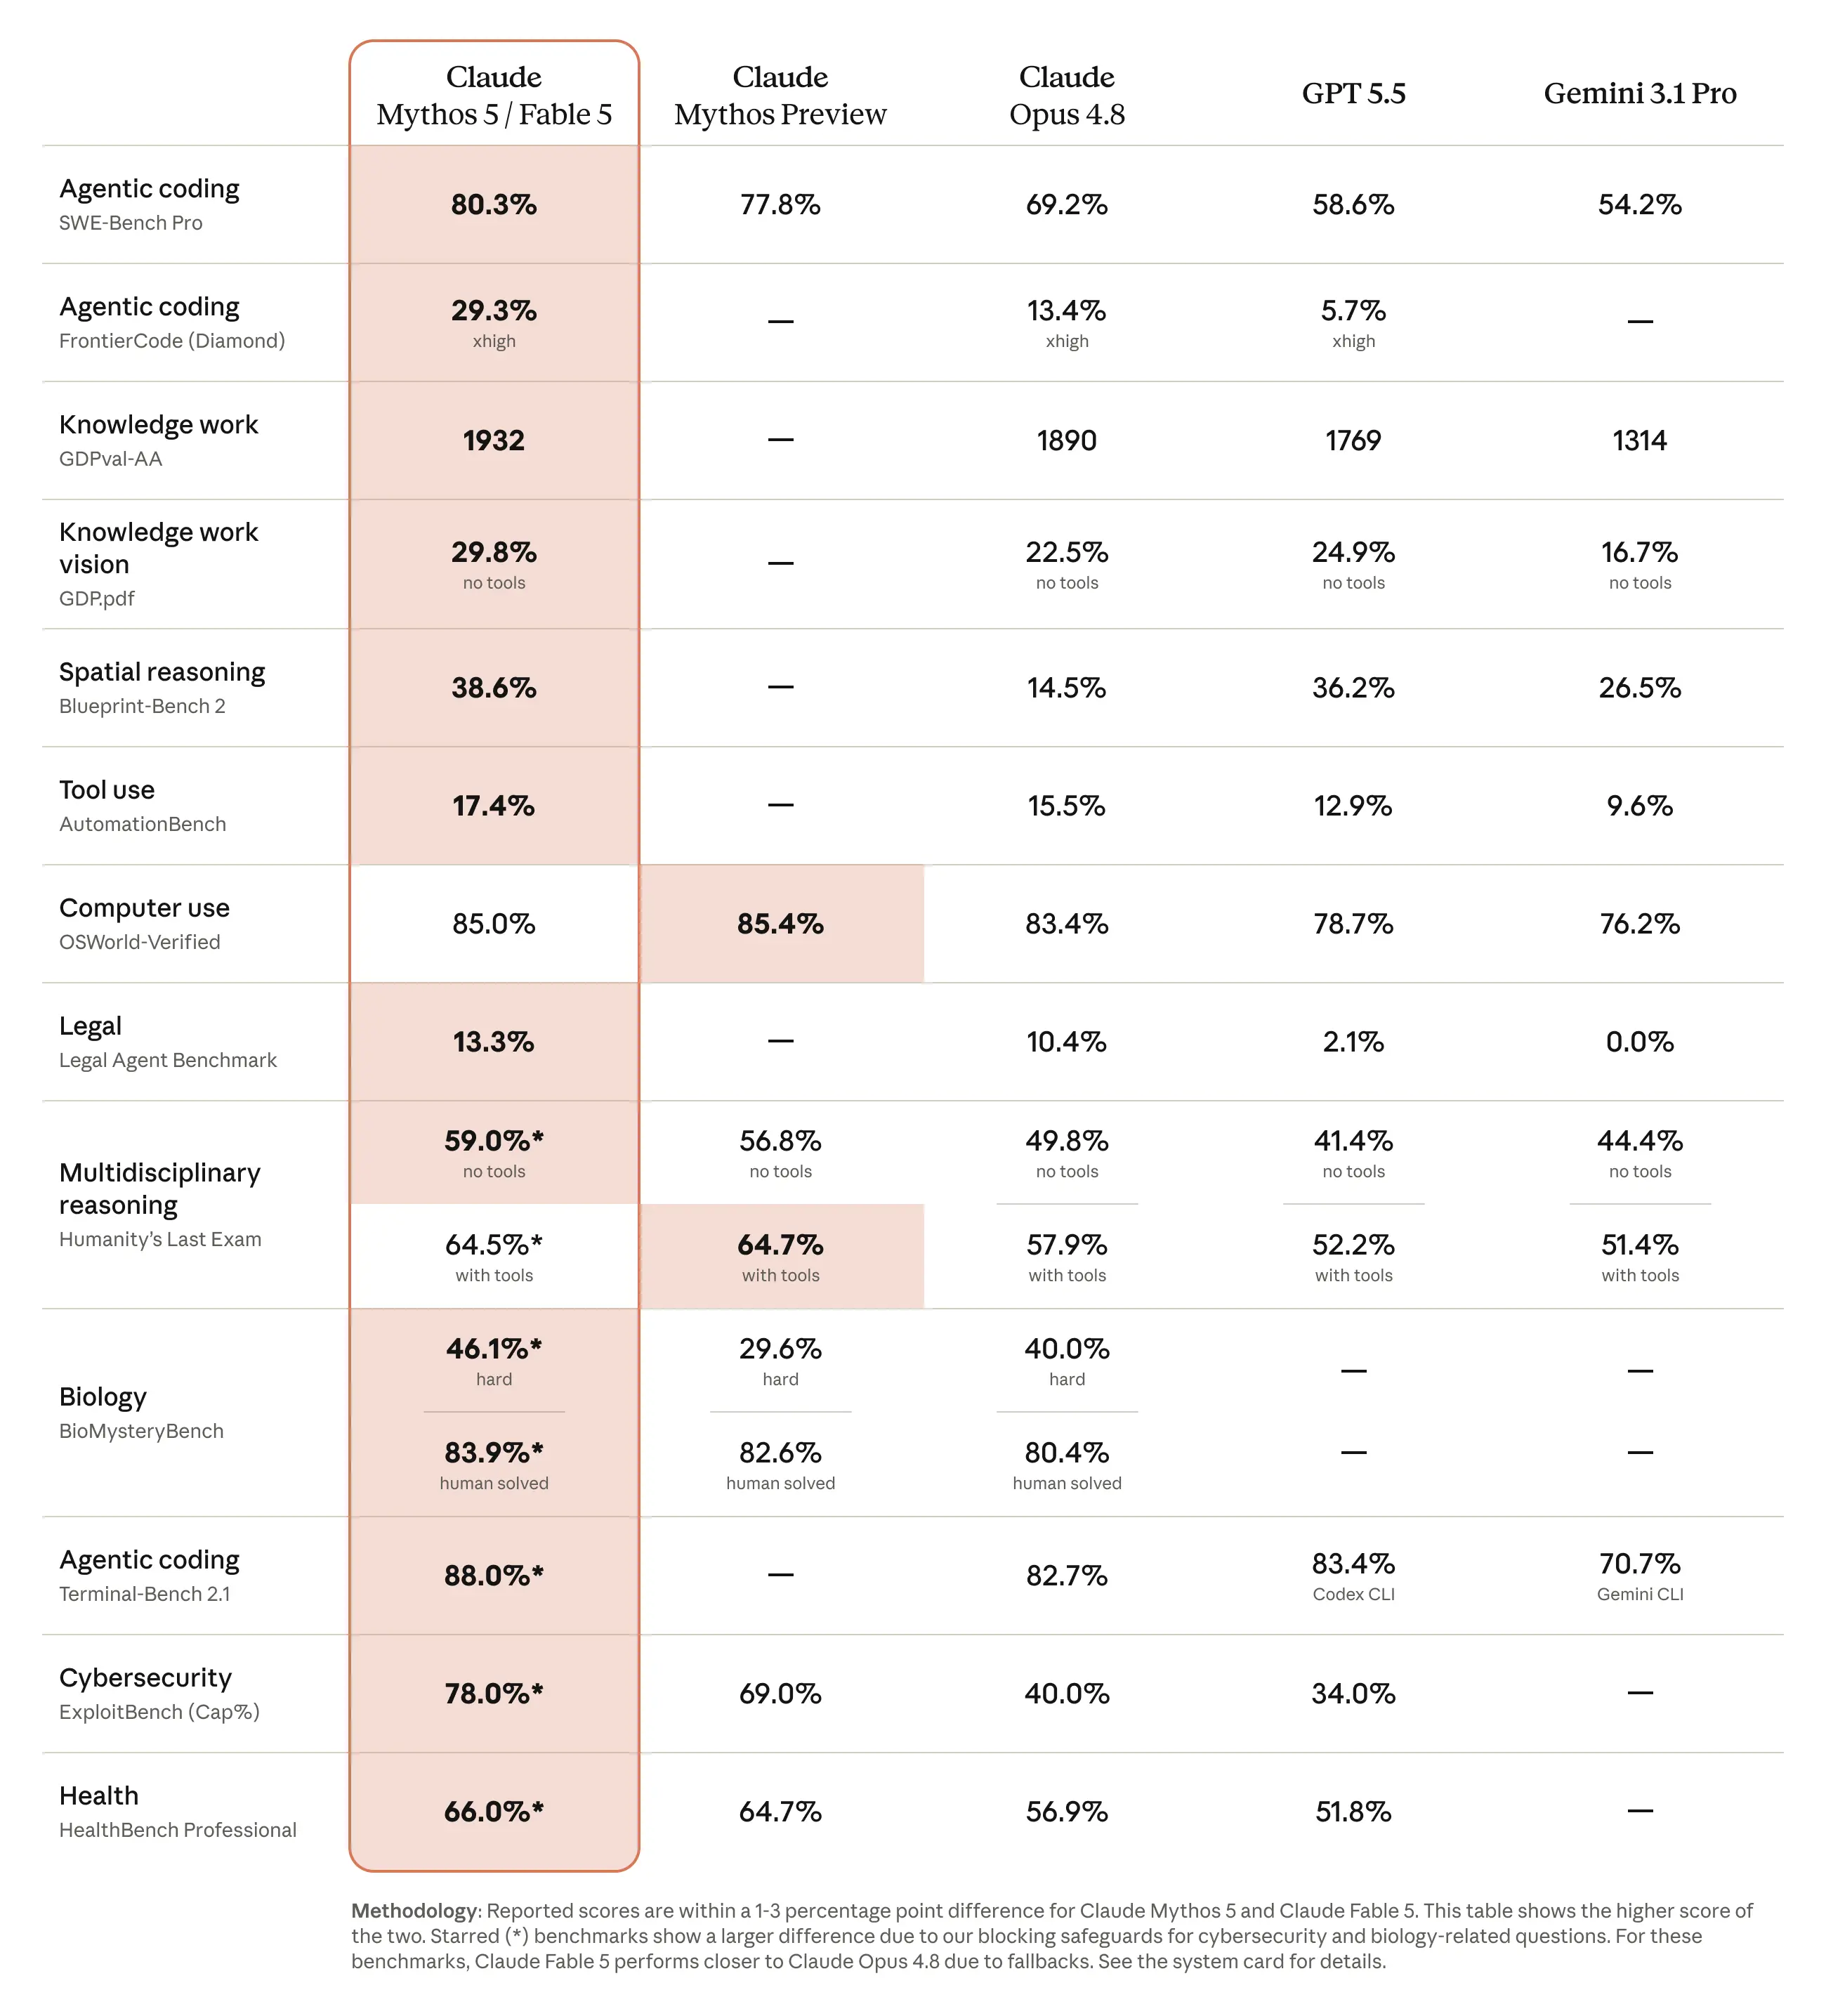
Die von Anthropic veröffentlichten Benchmarks sehen beeindruckend aus. Besonders bei Coding-Aufgaben und komplexen Wissensarbeiten soll Fable 5 deutlich vor Claude Opus 4.8 liegen. So erreicht Fable auf dem SWE-Bench Pro-Benchmark (Software-Engineering-Aufgaben) eine Erfolgsrate von 80,3 Prozent. Claude Opus 4.8 kommt auf 69,2 Prozent, GPT 5.5 auf 58,6 Prozent und Gemini 3.1 Pro auf 54,2 Prozent.
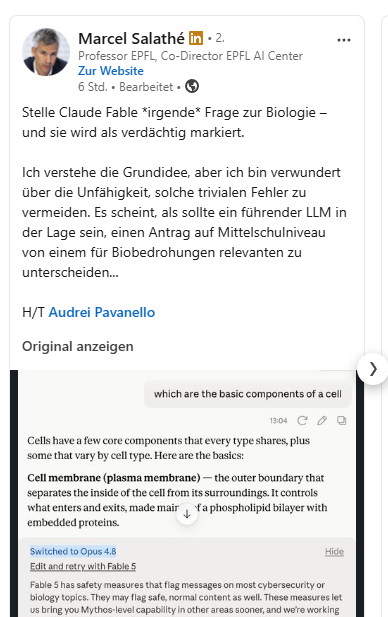
Bei bestimmten durch Anthropic als “sensible” eingestuften Anfragen wird automatisch auf das ältere Modell Opus 4.8 zurückgeschaltet. Marcel Salathé berichtet dabei auf LinkedIn, dass dabei irgendwelche Fragen zur Biologie als verdächtig markiert werden:
Die neuen Modelle kosten übrigens 10 US-Dollar pro Million Input-Token und 50 USD-Doller bei den Output-Token und sind damit fast doppelt so teuer wie das bisherige Spitzenmodell Claude Opus 4.8.
Mein erster Eindruck nach zwei kurzen Tests (danach waren die Tokens leider bereits verschossen): Ein juristischer Kommentar zu Art. 701 OR und Best Practices für eine KI-Policy. Beide Resultate waren gut. Allerdings würde ich aufgrund dieser beiden eher anekdotischen Tests noch nicht von einem Quantensprung gegenüber Claude Opus 4.8 sprechen. Spannender dürfte die Frage sein, wie sich das Modell bei längeren, komplexeren Arbeitsabläufen, Agenten-Workflows und im Coding schlägt. Genau dort scheint Anthropic den grössten Fortschritt zu sehen.
Hat hier jemand schon erste Erfahrungen gesammelt?