Juristische Fragen zum Deutschen Recht: Trefferquoten der neusten Gemini-Modelle und GPT 5
Markus Conrads und Sascha Schweitzer haben erneut LLMs mit Rechtsfragen aus dem deutschen Recht konfrontiert, dieses Mal die neusten Gemini-Modelle und GPT5. Ihre vorherige Studie erschien vor einigen Monaten in der NJW (Markus Conrads/Sascha Schweitzer, Juristische Problemlösung mit KI – Leistung und Grenzen großer Sprachmodelle, NJW 2025, 2888 ff.). Nun hat Prof. Conrads auf LinkedIn ein Update veröffentlicht, mit frischen Ergebnissen auf Basis von 200 komplexen Multiple-Choice-Fällen aus BGB AT, Schuldrecht, Wirtschafts- und Arbeitsrecht.
Mit aktiviertem Thinking Mode erzielen die Modelle gemäss Conrads folgende Gesamtergebnisse:
• Gemini 3 Pro: 79,5 %
• ChatGPT-5 High Effort: 78 %
• Gemini 2.5 Pro: 75 %
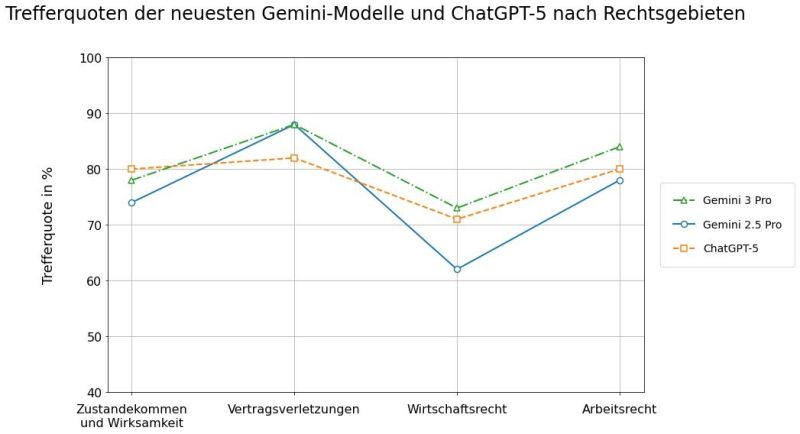
Beeindruckend finde ich. Heutzutage ist im KI-Diskurs oft von Halluzinationen grosser Sprachmodelle und dem daraus resultierenden Verifikationsaufwand die Rede. Die vorliegende Auswertung zeigt jedoch eindrücklich, wie leistungsfähig moderne Modelle inzwischen bei klar strukturierten, klausurähnlichen Rechtsfragen sind: Mit Trefferquoten zwischen 75 % und fast 80 % bewegen sie sich bereits im Bereich solider Examensleistungen.
Ich finde das einen bemerkenswerten Wert, zumal (so verstehe ich die Auswertung) weder juristische Datenbanken noch zusätzliche Quellen angebunden waren (Stichwort RAG). Interessant wäre auch ein Vergleich, wie menschliche Juristen in denselben Tests abschneiden würden. Ich vermute: Ebenfalls nicht bei 100% …