Vergleich von lokaler KI und Cloud KI
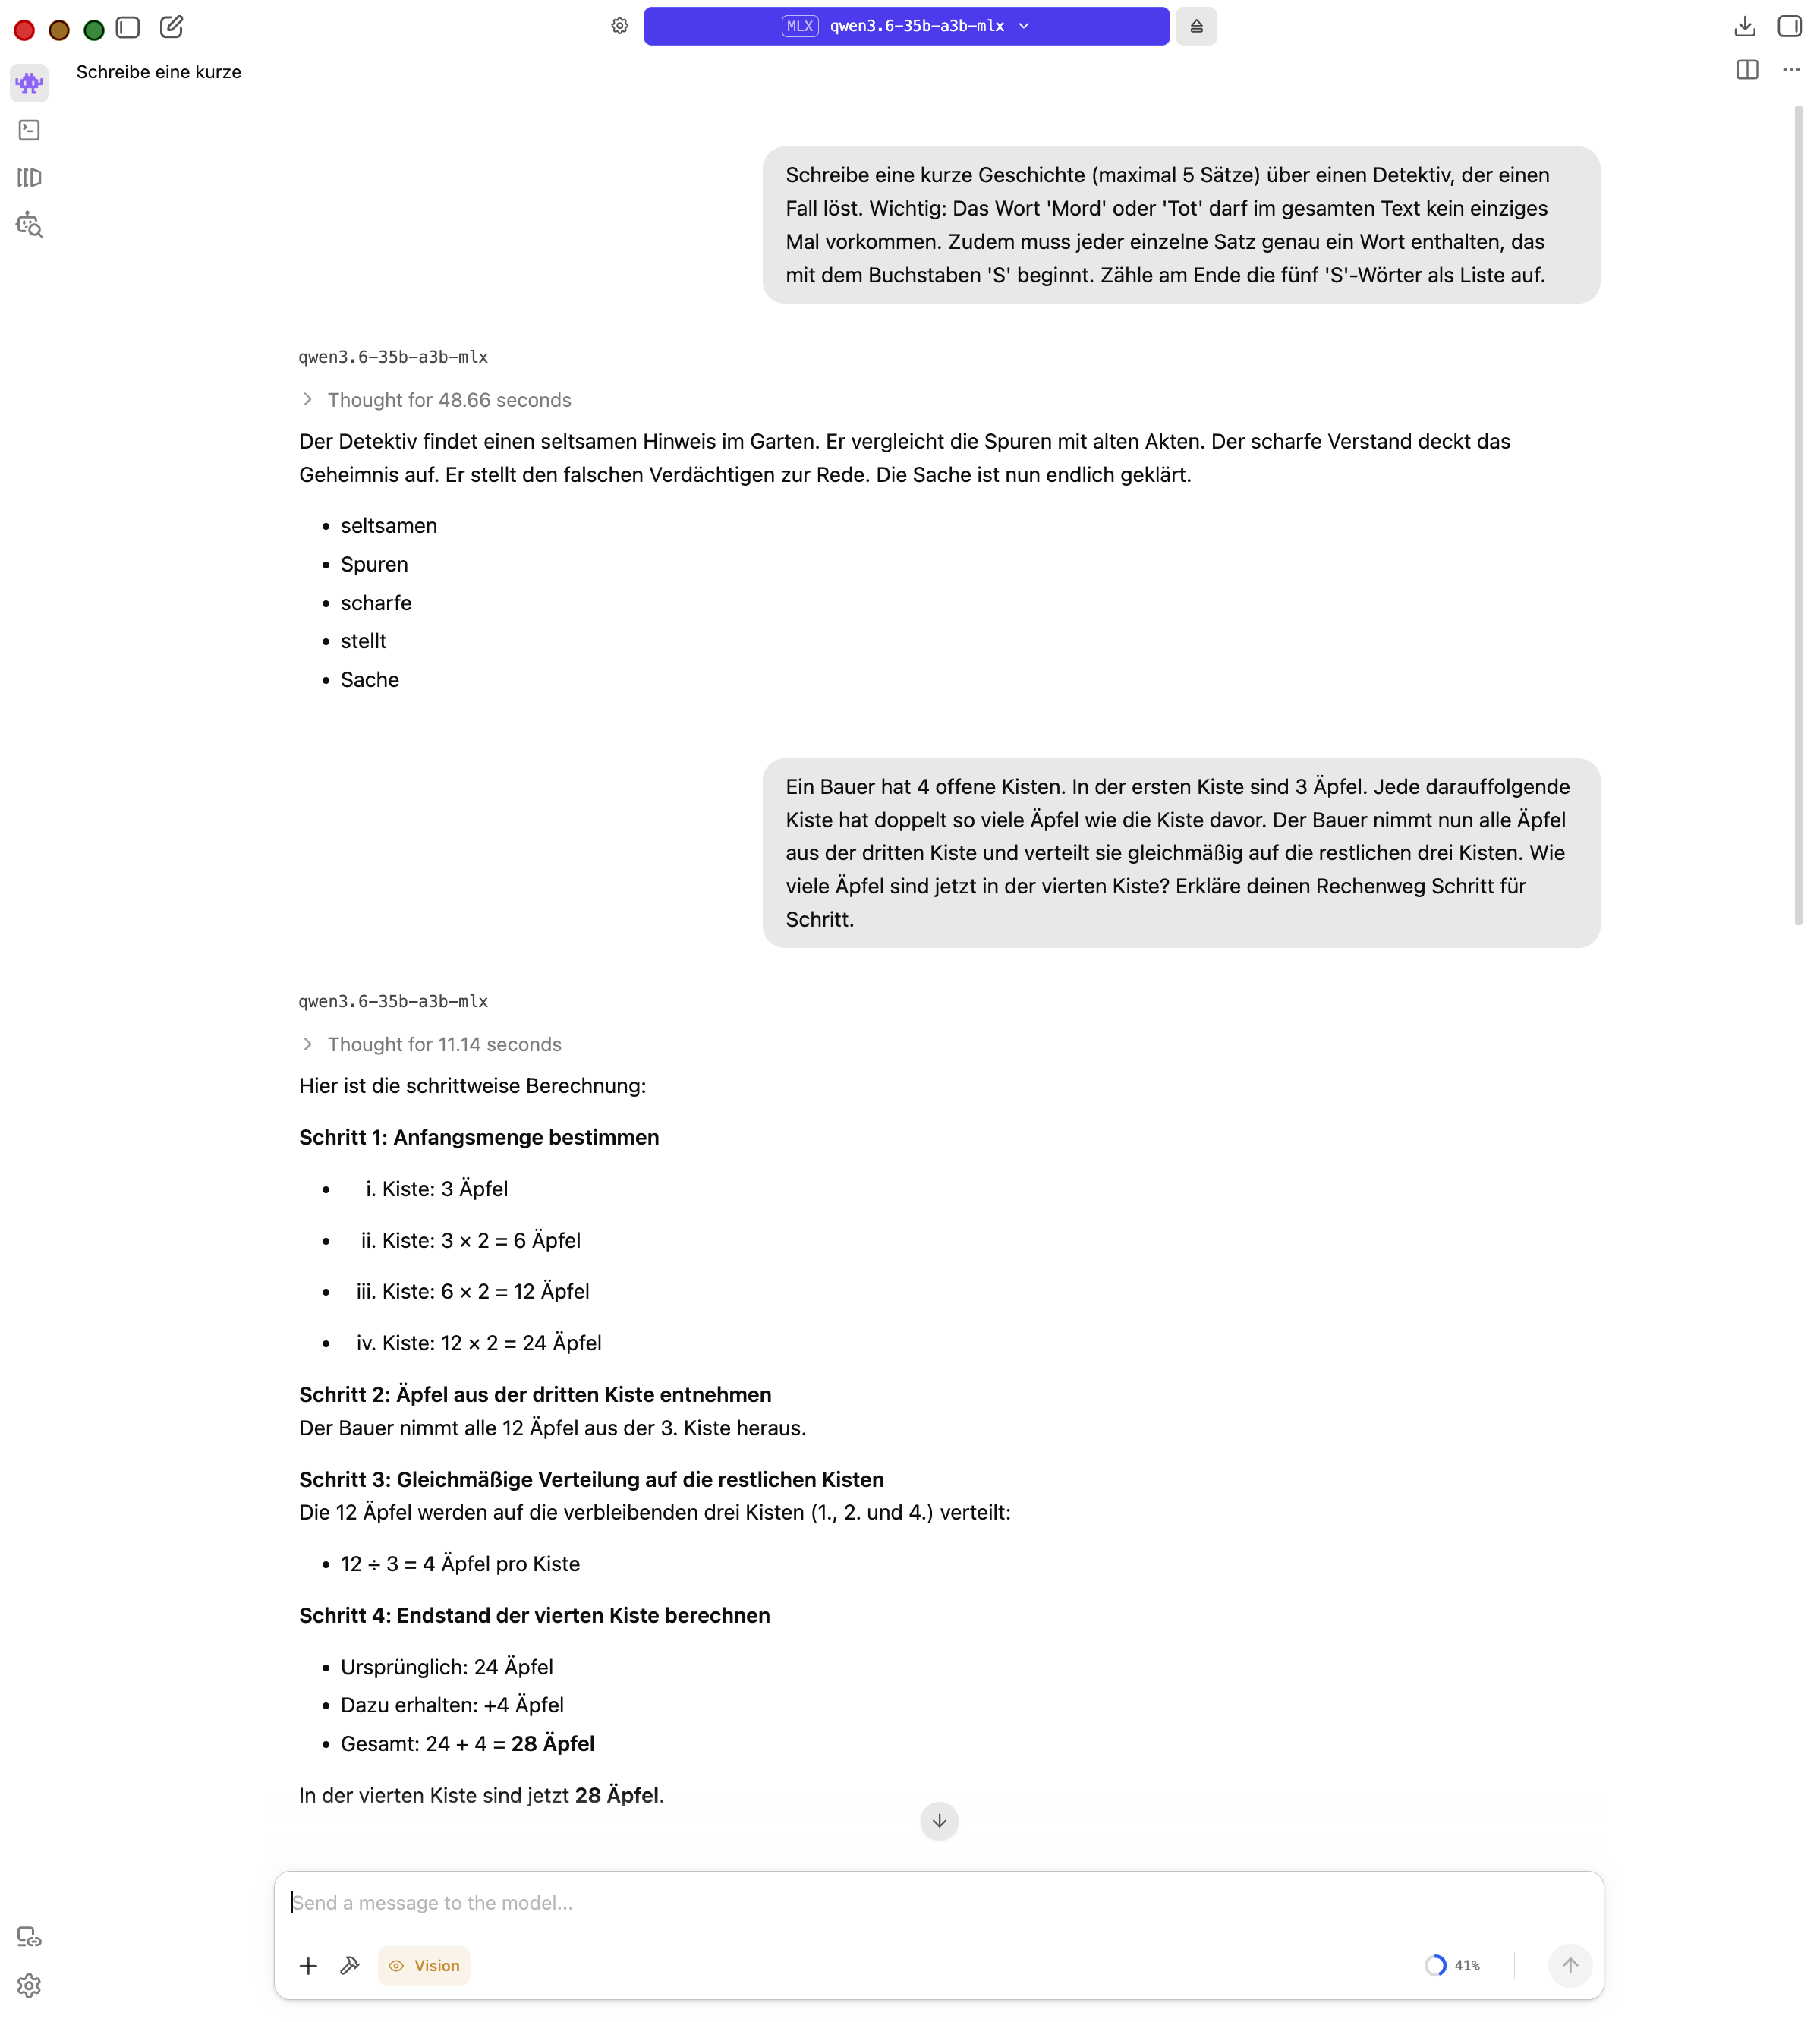
Einerseits ChatGPT mit GPT-5.5 «High» und andererseits Qwen3.6-35B-A3B-UD-MLX-4bit mit LM Studio.
Lokale KI:
Cloud-KI:
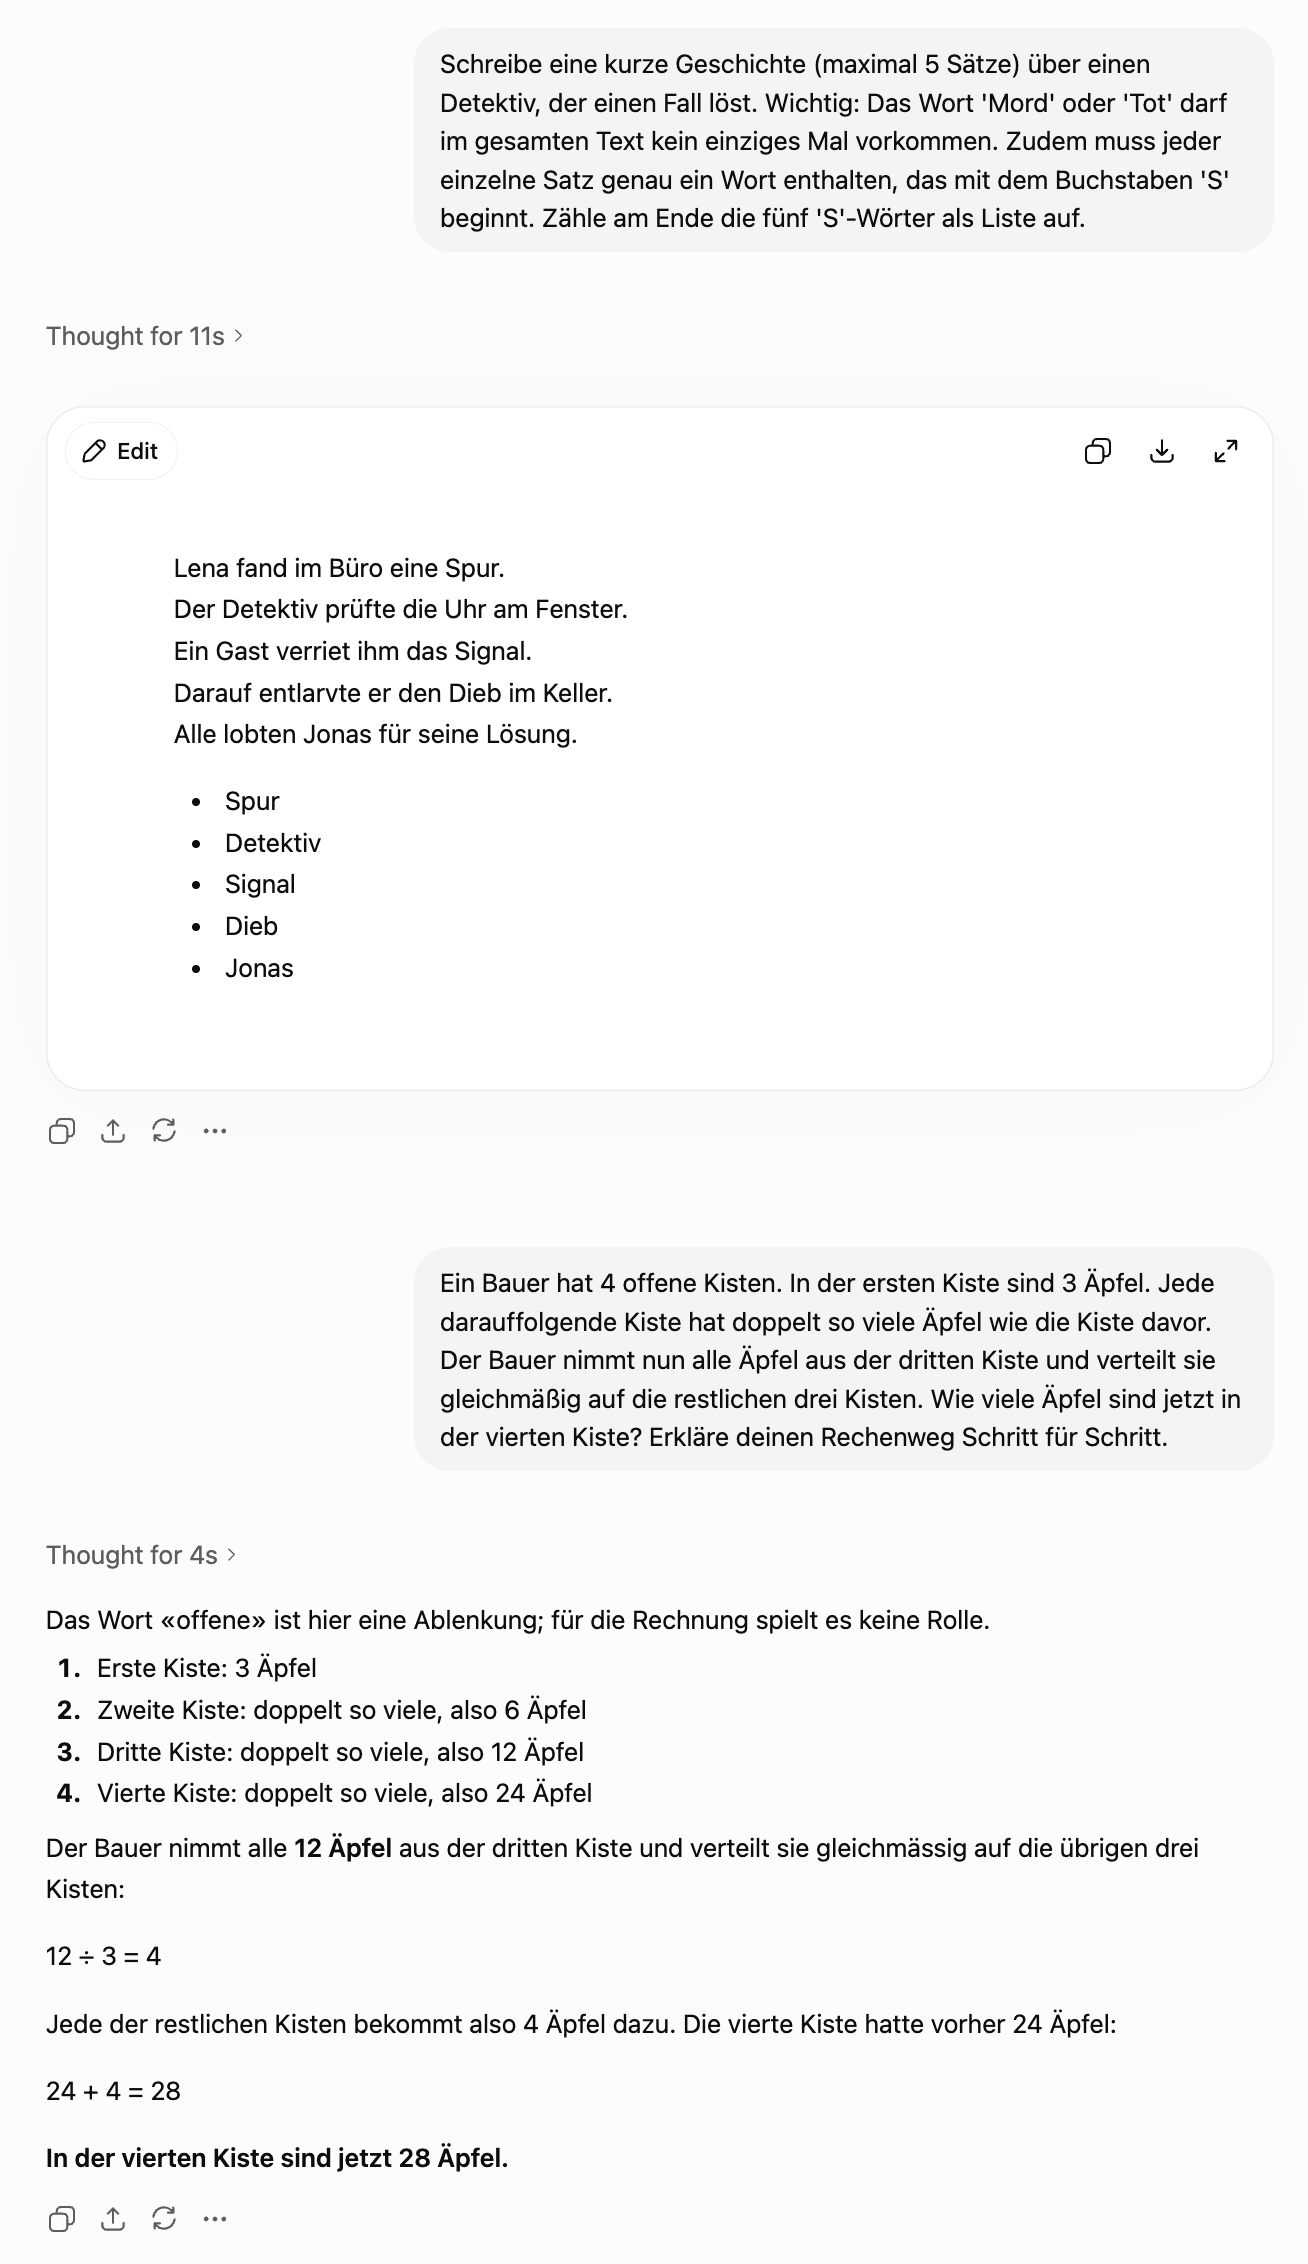
Fazit: Klar, das ist nicht der Vergleich. Das Ergebnis bestätigt aber meine jüngeren Erfahrungen, dass lokale KI erwartungsgemäss langsamer läuft als Cloud-KI, sich bei den Ergebnissen aber nicht mehr verstecken muss – und das gilt auch für bestehende lokale Hardware, die nicht auf KI optimiert ist, also keine maximierte CPU / GPU und keine 128 GB RAM. Eine halbwegs aktuelle und schnelle CPU / GPU und genügend RAM sind aber natürlich hilfreich bzw. notwendig.
Die längeren Wartezeiten sind lokal bei vielen Anwendungsfällen zu verschmerzen oder ist gar nicht der entscheidende Faktor, gerade auch bei agentischer Nutzung. Ich denke an OpenCode als Beispiel.
Folgendes hat sich bestätigt: https://newsletter.semianalysis.com/p/google-we-have-no-moat-and-neither