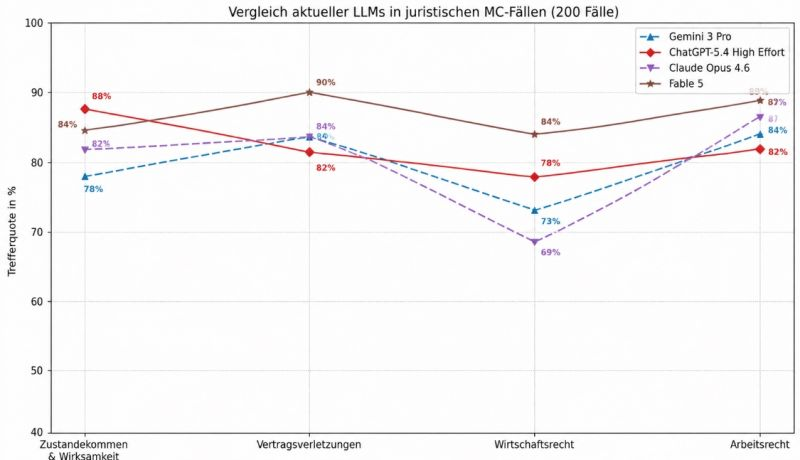
Deutscher Rechtsbenchmark: LLM Spitzengruppe mit Treffenquoten von 80%
Markus Conrads und Sascha Schweitzer haben erneut LLMs mit Rechtsfragen aus dem deutschen Recht konfrontiert. Die Benchmark basiert auf 200 juristischen Multiple-Choice-Fällen aus den Bereichen BGB AT (Zustandekommen und Wirksamkeit), Vertragsverletzungen, Wirtschaftsrecht und Arbeitsrecht. Die Spitzenmodelle (Gemini 3 Pro, ChatGPT 5.4, Claude Opus 4.6 und Fable 5) erreichend Trefferquoten von rund 80%!
Als Vergleich: Im Jahr 2023 erzielte das damalige Spitzenmodell ChatGPT-4 lediglich rund 50 % richtige Antworten. Zu den Werten im Dezember 2025: #Juristische Fragen zum Deutschen Recht: Trefferquoten der neusten Gemini-Modelle und GPT 5
Die Resultate bestätigen einen Trend, den wir bei der täglichen (juristischen) Arbeit mit den KI-Modellen spüren, nämlich dass sie merklich besser werden. Gleichzeitig muss betont werden, dass das Benchmarking von LLMs für die juristische Arbeit aufgrund der argumentationsgetriebenen Arbeit der Juristerei komplex und die Bestimmung eines Benchmarks schwierig ist. Ein Multiple-Choice-Format, wie es hier vorliegt, misst die Fähigkeit, aus vorgegebenen Antworten die richtige zu wählen, nicht aber die eigenständige Subsumtion und Argumentation. Trefferquoten von 80% sind also insoweit mit Vorsicht zu geniessen. Und eine Trefferquote von 80 Prozent heisst im Umkehrschluss, dass rund jede fünfte Antwort falsch ist.
Wer LLMs in der Rechtsanwendung einsetzt, kommt deshalb um eine sorgfältige Verifikation noch immer nicht herum, denn die 80/20 Regel gilt im Rechtsbereich (allermeistens) nicht. Oder positiv gedreht: Der Benchmark zeigt, dass es uns weiterhin braucht.